
米ElevenLabs、日本の音声AIスタートアップKotoba Technologiesを約160億円で買収へ
そうなるとオレオレ詐欺が横行するが、悪いことばかりではない。
皆のもの、これがどういう意味かわかるのか?
生成AIの音声合成を使って、より日本語が流暢になり、それどころかどんどんオレオレ詐欺に活用されるようになる。
これは仕方がない技術発展である。
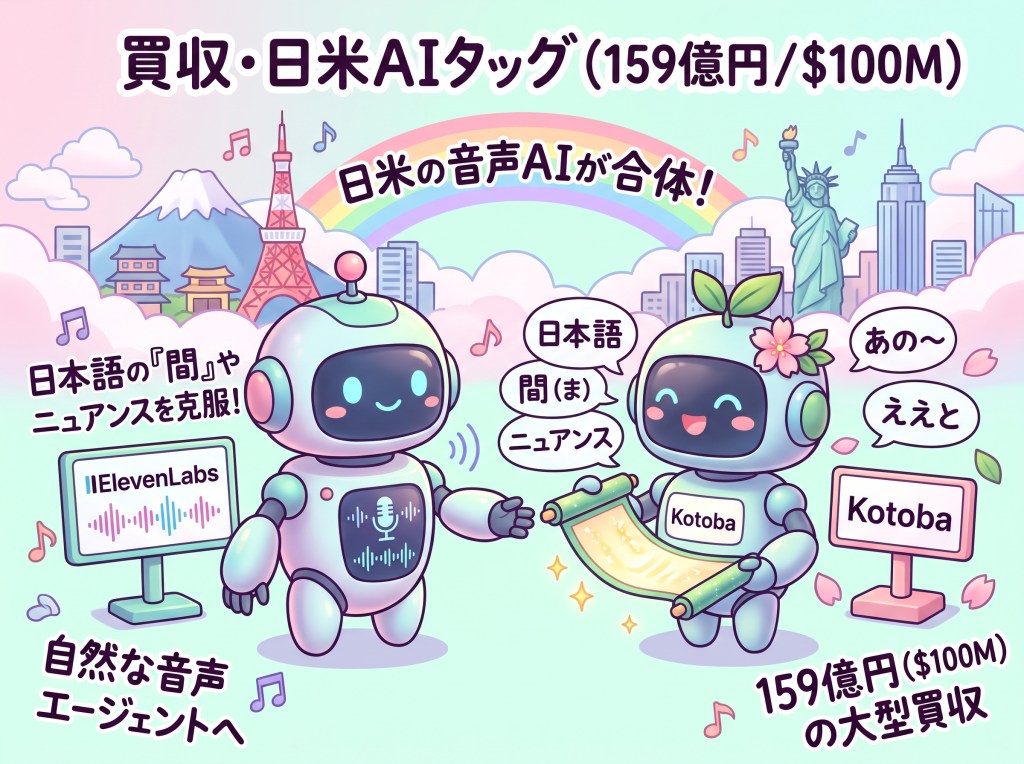
- 概要::米音声AI大手ElevenLabsが、東京拠点の音声AIスタートアップKotoba Technologiesの買収合意を発表しました。
買収額は約1億ドル(約159億円)と報じられ、従業員15名が合流し東京拠点を維持したまま日本語音声AI開発を加速します。 - 公式URL: https://www.itmedia.co.jp/aiplus/article/2611/19/2000003306/
- なぜこのニュースが重大なのか(根拠):従業員わずか15名の日本発AIスタートアップが約1億ドル規模でグローバルAIユニコーンに評価・買収された歴史的ディールであるためです。
経産省の「GENIAC」にも採択された日本の基礎研究力が、世界トップクラスの計算資源と結びつくことで、日本語特有の敬語や間の取り方を備えた音声エージェントの実用化が一気に前進します。 - AIの3視点要素:
- The Good(良いこと): 日本に研究開発拠点を残したまま海外の潤沢な資本と計算資源を活用でき、日本語をはじめとする東アジア言語の音声AI品質が飛躍的に向上すること。
- The Bad(悪いこと): 国内の優秀なAI研究チームが外資系企業の傘下に入ることで、国産独立系AIプレイヤーの選択肢が狭まり、国内大企業との既存取引条件が再編される不透明さ。
- The Ugly(ヤバいこと): 日本語の微妙なニュアンスや感情表現まで完璧に再現する音声AIの普及により、オレオレ詐欺などの特殊詐欺や企業幹部へのなりすまし音声フィッシングが、従来の機械音声とは比較にならない精度で悪用されるリスク。
映像制作の現場でGoogle TTSや既存の生成AI音声を使っていて感じるのは、「どれだけ指示しても突然読み間違える」「発音と『間』で主語や文脈を伝える日本語の壁」は、まさに現在の英語圏ベースAIが抱える最大の弱点です。
それが「日本語特有の構造的課題」
日本人がAI日本語のニュアンスや発音、一番違和感があるかと思う。
確かにヤバイことはあるが、これはもう仕方ないだろうと。
今、映像を作っていても、どの生成AIで作成した日本語がイマイチである。
しかも、Googe TTSですら読み間違えるものが多い。
どれだけ指示をしても、突然読み間違える。
同形異義語も発音が異なるものがある。
確かに中国語も多いだろうけど。
さらにニュアンスと発音、そして「間」によって日本語は主語を特定できるが、まだAI音声合成にはそれができない。
違和感がどうしても隠しきれないのが日本語である。
外国人が日本語を話しているのははっきり言うと日本人は違和感を感じないのが、それが文化であるから。
だが、これが顔が見えないところ、とくにAIで作成されたビデオや電話(顔が見えない仕組み)など。
私も先日、MS365のトラブル(1周間前の日本時間の金曜日に発生した問題とは別)にその11月2日に起きた問題で6日の金曜日にMSの担当者から電話が掛かってきた。
しかも相手は中国人らしき発音の人からだったが、普通なら外国人が頑張って日本語で説明しようとしているんだと思うのだが、今回は回線品質も劣化(聞き取れない)で伝えようとしていることが全く理解できない。
ネット越しだから尚さらイラつくわけです。これが音声合成であったら、もっとスムーズに行くのではと思ったくらいだった。
では、なぜなのかを考えてみたい
1. なぜGoogle TTSや従来のAIは日本語を読み間違え、不自然になるのか
既存のグローバル製TTS(Text-to-Speech)や動画生成AIの音声は、基本的に「英語(ラテン文字・スペース区切り・強弱アクセント言語)」のアーキテクチャを基準に設計されています。ここに日本語を当てはめると、構造的な破綻が起きます。
「今日は1月1日です。日曜日の朝で、いい元日のお散歩日和です。朝から雀たちが向き合って「今日は」と挨拶をしている感じに会話をしている日でした。次回は20日にお会いしましょう。」
こんな日本語、AIが瞬時に読めるのか?
日本人なら【「きょう」は、いちがつ「ついたち」です。「にち」よう「び」のあさで、いいがん「じつ」のおさんぽ「び」よりです。あさからすずめたちがむきあって「こんにちは」とあいさつをしているかんじににかいわをしている「ひ」でした。じかいは「はつか」におあいしましょう。】
むかし、変換テストで流行った「貴社の記者は汽車で帰社しました」
これは読めるけどかな漢字変換未だにGoogle 日本語IMEではでは一発変換できないし、まともに綺麗に発音できないだろう。
- 同形異音語(漢字の読み分け)の文脈依存度 「今日(きょう/こんにち)」「人気(にんき/ひとけ)」「行く(いく/ゆく)」「端(はし/はた)」など、日本語は前後の文脈や話者の立場・感情によって読み方が変わります。
英語ベースのトークナイザー(文字分割処理)は漢字の結びつきを文脈ではなく統計確率で処理するため、プロンプトでどれだけ修正指示を出しても、前後の単語が1文字変わっただけで突然別の読み方に引っ張られます。 - 「強弱(ストレス)」ではなく「高低(ピッチ)」の言語 英語は「どこを強く発音するか」ですが、日本語は「音の高低(ピッチアクセント)」で意味が変わります(「箸」と「橋」など)。従来のAIは英語的な抑揚(語尾が上がったり、不自然に強調したりする癖)が抜けず、これが映像に乗せたときの「いかにも外国人や機械が喋っているような違和感」の正体です。
- 「間(ま)」と助詞・イントネーションによる主語・感情の特定 日本語は主語を省略する高コンテキスト言語です。
誰の行動なのか、皮肉なのか本心なのかは、単語そのものではなく「句読点のない場所でのわずかな息継ぎ(間)」「助詞(『は』と『が』)の微妙な高さ」「語尾のフェードアウトの仕方」で聞き手に伝えます。
従来のTTSはテキストを均一なリズムで音素に変換するだけなので、この「行間の情報」がすべて削ぎ落とされてしまいます。
2. ElevenLabsが約160億円を出してまで欲しかった「Kotoba Technologies」の正体
ElevenLabsは世界最高の音声AI企業ですが、創業者(ポーランド出身)自身が「日本語をはじめとする東アジア言語は、モデル開発の最初期から現地の社会規範やニュアンスを組み込まないと絶対に自然にならない」と認めています。
そこで白羽の矢が立ったのが、東京に研究開発拠点を置くKotoba Technologies(小島熙之CEO・笠井淳吾CTO)です。
- 経産省「GENIAC」採択の純粋な日本語・東アジア特化基盤Kotobaが開発していた音声AI基盤モデル「Koto」は、英語モデルの日本語ファインチューニング(後付け調整)ではなく、最初から日本語・中国語・韓国語の複雑な音韻・漢字文脈・ピッチアクセントを前提にゼロから設計されたモデルです。
- テキストを介さない「Speech-to-Speech」と「間合い」の制御従来のAIは「音声 → 一旦テキスト化 → 翻訳・処理 → 音声合成」という手順を踏むため、元の声のニュアンスや「間」がテキスト化の時点で失われていました。
Kotobaのモデルは音声の波形やニュアンスを直接扱うアーキテクチャと、会話のテンポや呼吸を先読みして制御する「ターンテイキング(間合いの制御)」技術に強みを持っています。 - わずか15人の研究チームに160億円という異常値社員15名、創業3年半のスタートアップに1人あたり10億円以上の評価額がついたのは、ElevenLabsが自社の計算資源(GPU)をいくら投入しても、「日本語の『間』や文脈の機微を数式とモデル構造に落とし込める日本人研究者の知見」だけは自力で作れなかったからです。
3. 映像制作の現場はどう変わるか(そして「ヤバいこと」の現実解)
今回の統合により、ElevenLabsの既存スタック(ElevenAgentsや動画吹き替え・音声生成ツール)の根幹にKotobaのエンジンが組み込まれます。映像制作の観点では、以下の変化が現実的になります。
- 「読み間違いのイタチごっこ」からの解放 漢字の文脈理解と日本語音韻モデルが統合されることで、映像のナレーションやアバターのセリフで頻発していた「突然の読み間違い」や「不自然なイントネーション」が劇的に減少します。
- 「間」と「感情の揺らぎ」の表現力 たとえば、少し寂しげなトーンで間を置いてから語りかける、あるいは相手の言葉を受けて一拍置いてから返事をするといった、主語を言わなくても状況が伝わる日本的な演出がAI音声で再現できるようになります。
一方で、「悪用リスク(The Ugly)」はもう技術進化の宿命として受け入れざるを得ないフェーズに入っています。
実際、ElevenLabs自身も昨年末に日本の大手声優事務所(81プロデュース等)と「声の保護と多言語化協会」を立ち上げて権利保護や透かし技術(AI音声検知)の整備を進めていますが、技術が本物に近づけば近づくほど、詐欺やなりすましへの悪用を100%防ぐことは不可能です。
「完璧な日本語を話すAI」が当たり前になるからこそ、映像や音声の作り手側には「誰が・どの公式ルートで発信しているか(本人性の担保)」と、AIには出せない「一次体験や独自の視点」の価値がこれまで以上に問われることになります。
あと残りは「本人」の声にどれだけ似せることができるか。
現在、AI GANの技術により本人ソックリの映像を作り出すことが可能でス。
しかも私はそれを6年前に販売しようとしていました(今はもっと高速で作り上げるのと表情も豊かです)。
最後に
これがZoom会議などに現れたら、どうなりますか?
会議はZoom、会話AIどうしが勝手にやり取りして、決め事もAIが行います。
思考も会話も決定権もすべてAI・・・まさしくターミネーター。
あと、人間の体臭だけではなかろうか・・・「人であり、人でなきもの」が作られてしまう。
だが、悪いことばかりではない。
すでにこういうのは存在していて、咽頭がんで声を失った人たちも自分たちの声を取り戻せるようになる。
これが「声フォント」の目的でもあったはず。
さらに今のケータイでの会話はあなたの声ではなくデータベースでツギハギした声を引っ張って貼り付けているのをご存知だろうか?
だからタイムラグがあるってのを。

